基础
make 与 new 的区别
1)作用变量类型不同,new给string,int和数组分配内存,make给切片,map,channel分配内存;
2)返回类型不一样,new返回指向变量的指针,make返回变量本身;
3)new 分配的空间被清零。make 分配空间后,会进行初始化;
数组和切片的区别
1)数组是定长,访问和复制不能超过数组定义的长度,否则就会下标越界,切片长度和容量可以自动扩容
2)数组是值类型,切片是引用类型,每个切片都引用了一个底层数组,切片本身不能存储任何数据,都是这底层数组存储数据,所以修改切片的时候修改的是底层数组中的数据。切片一旦扩容,指向一个新的底层数组,内存地址也就随之改变
方法与函数的区别?
在Go语言中,函数和方法不太一样,有明确的概念区分。其他语言中,比如Java,一般来说函数就是方法,方法就是函数;但是在Go语言中,函数是指不属于任何结构体、类型的方法,也就是说函数是没有接收者的;而方法是有接收者的。
//方法
func (t *T) add(a, b int) int {
    return a + b
}
// 其中T是自定义类型或者结构体,不能是基础数据类型int等

//函数
func add(a, b int) int {
    return a + b
}
方法值接收者和指针接收者的区别?
如果方法的接收者是指针类型,无论调用者是对象还是对象指针,修改的都是对象本身,会影响调用者;
如果方法的接收者是值类型,无论调用者是对象还是对象指针,修改的都是对象的副本,不影响调用者;
type Person struct {
    age int
}

// 如果实现了接收者是指针类型的方法,会隐含地也实现了接收者是值类型的IncrAge1方法。
// 会修改age的值
func (p *Person) IncrAge1() {
    p.age += 1
}

// 如果实现了接收者是值类型的方法,会隐含地也实现了接收者是指针类型的IncrAge2方法。
// 不会修改age的值
func (p Person) IncrAge2() {
    p.age += 1
}

// 如果实现了接收者是值类型的方法,会隐含地也实现了接收者是指针类型的GetAge方法。
func (p Person) GetAge() int {
    return p.age
}

func main() {
    // p1 是值类型
    p := Person{age: 10}

    // 值类型 调用接收者是指针类型的方法
    p.IncrAge1()
    fmt.Println(p.GetAge()) //11
    // 值类型 调用接收者是值类型的方法
    p.IncrAge2()
    fmt.Println(p.GetAge()) //11

    // ----------------------

    // p2 是指针类型
    p2 := &Person{age: 20}

    // 指针类型 调用接收者是指针类型的方法
    p2.IncrAge1()
    fmt.Println(p2.GetAge()) //21
    // 指针类型 调用接收者是值类型的方法
    p2.IncrAge2()
    fmt.Println(p2.GetAge())//21
}
函数返回局部变量的指针是否安全?
一般来说,局部变量会在函数返回后被销毁,因此被返回的引用就成为了”无所指”的引用,程序会进入未知状态。
但这在 Go 中是安全的,Go 编译器将会对每个局部变量进行逃逸分析。如果发现局部变量的作用域超出该函数,则不会将内存分配在栈上,而是分配在堆上,因为他们不在栈区,即使释放函数,其内容也不会受影响。
func add(x, y int) *int {
res := 0
res = x + y
return &res
}

func main() {
fmt.Println(add(1, 2))
}

// 编译时可以借助选项 -gcflags=-m,查看变量逃逸的情况
./main.go:6:2:          res escapes to heap:
./main.go:6:2:        flow: ~r2 = &res:
./main.go:6:2:     from &res (address-of) at ./main.go:8:9
./main.go:6:2:     from return &res (return) at ./main.go:8:2
./main.go:6:2:         moved to heap: res
./main.go:12:13: ... argument does not escape 0xc0000ae008

res escapes to heap 即表示 res 逃逸到堆上了。
uintptr与unsafe.Pointer区别?
unsafe.Pointer 是通用指针类型,它不能参与计算,任何类型的指针都可以转化成 unsafe.Pointer,unsafe.Pointer 可以转化成任何类型的指针,uintptr 可以转换为 unsafe.Pointer,unsafe.Pointer 可以转换为 uintptr。uintptr 是指针运算的工具,但是它不能持有指针对象(意思就是它跟指针对象不能互相转换),unsafe.Pointer 是指针对象进行运算(也就是 uintptr)的桥梁。
Slice
array和slice的区别?
数组长度不能改变,初始化后长度就是固定的;切片的长度是不固定的,可以追加元素,在追加时可能使切片的容量增大。
结构不同,数组是一串固定数据,切片描述的是截取数组的一部分数据,从概念上说是一个结构体。
初始化方式不同,如上。另外在声明时的时候:声明数组时,方括号内写明了数组的长度或使用...自动计算长度,而声明slice时,方括号内没有任何字符。
函数调用时的传递方式不同,数组按值传递,slice按引用传递。
func main() {

    s := []int{1, 2, 3}
    s1 := s[0:1]
    PrintSlice(s1) // [1,4]

    fmt.Println(s)  // [1,4,3]
    fmt.Println(s1) // [1]
}
func PrintSlice(s []int) {
    s = append(s, 4)

    fmt.Println(s)
}
slice深拷贝和浅拷贝
深拷贝:拷贝的是数据本身,创造一个新对象,新创建的对象与原对象不共享内存,新创建的对象在内存中开辟一个新的内存地址,新对象值修改时不会影响原对象值、
实现深拷贝的方式:
- copy(slice2, slice1)
- 遍历append赋值
func main() {
    slice1 := []int{1, 2, 3, 4, 5}
    slice2 := make([]int, 5, 5)
    fmt.Printf("slice1: %v, %p", slice1, slice1)

    copy(slice2, slice1)
    fmt.Printf("slice2: %v, %p", slice2, slice2)
    slice3 := make([]int, 0, 5)
    for _, v := range slice1 {
        slice3 = append(slice3, v)
    }
    fmt.Printf("slice3: %v, %p", slice3, slice3)
}
slice1: [1 2 3 4 5], 0xc0000b0030
slice2: [1 2 3 4 5], 0xc0000b0060
slice3: [1 2 3 4 5], 0xc0000b0090
浅拷贝:拷贝的是数据地址,只复制指向的对象的指针,此时新对象和老对象指向的内存地址是一样的,新对象值修改时老对象也会变化
func main() {
    slice1 := []int{1, 2, 3, 4, 5}
    fmt.Printf("slice1: %v, %p", slice1, slice1)
    slice2 := slice1
    fmt.Printf("slice2: %v, %p", slice2, slice2)
}
slice1: [1 2 3 4 5], 0xc00001a120
slice2: [1 2 3 4 5], 0xc00001a120
slice扩容机制?
扩容会发生在slice append的时候,当slice的cap不足以容纳新元素,就会进行扩容,扩容规则如下
- 如果新申请容量比两倍原有容量大,那么扩容后容量大小 为 新申请容量
- 如果原有 slice 长度小于 1024, 那么每次就扩容为原来的 2 倍
- 如果原 slice 长度大于等于 1024, 那么每次扩容就扩为原来的 1.25 倍
func main() {
    slice1 := []int{1, 2, 3}
    for i := 0; i < 16; i++ {
        slice1 = append(slice1, 1)
        fmt.Printf("addr: %p, len: %v, cap: %v", slice1, len(slice1), cap(slice1))
    }
}
addr: 0xc00001a120, len: 4, cap: 6
addr: 0xc00001a120, len: 5, cap: 6
addr: 0xc00001a120, len: 6, cap: 6
addr: 0xc000060060, len: 7, cap: 12
addr: 0xc000060060, len: 8, cap: 12
addr: 0xc000060060, len: 9, cap: 12
addr: 0xc000060060, len: 10, cap: 12
addr: 0xc000060060, len: 11, cap: 12
addr: 0xc000060060, len: 12, cap: 12
addr: 0xc00007c000, len: 13, cap: 24
addr: 0xc00007c000, len: 14, cap: 24
addr: 0xc00007c000, len: 15, cap: 24
addr: 0xc00007c000, len: 16, cap: 24
addr: 0xc00007c000, len: 17, cap: 24
addr: 0xc00007c000, len: 18, cap: 24
addr: 0xc00007c000, len: 19, cap: 24
slice为什么不是线程安全的?
slice底层结构并没有使用加锁等方式,不支持并发读写,所以并不是线程安全的,使用多个 goroutine 对类型为 slice 的变量进行操作,每次输出的值大概率都不会一样,与预期值不一致; slice在并发执行中不会报错,但是数据会丢失
func TestSliceConcurrencySafe(t *testing.T) {
    a := make([]int, 0)
    var wg sync.WaitGroup
    for i := 0; i < 10000; i++ {
        wg.Add(1)
        go func(i int) {
            a = append(a, i)
            wg.Done()
        }(i)
    }
    wg.Wait()
    t.Log(len(a))
    // not equal 10000
}
扩容前后的 Slice 是否相同?
情况一:
原数组还有容量可以扩容(实际容量没有填充完),这种情况下,扩容以后的数组还是指向原来的数组,对一个切片的操作可能影响多个指针指向相同地址 的 Slice。
情况二:
原来数组的容量已经达到了最大值,再想扩容, Go 默认会先开一片内存区域,把原来的值拷贝过来,然后再执行 append() 操作。这种情况丝毫不影响 原数组。
要复制一个 Slice,最好使用 Copy 函数。
slice分配在堆上还是栈上
有可能分配到栈上,也有可能分配到栈上。当开辟切片空间较大时,会逃逸到堆上。
Channel
Go channel有什么特点?
channel有2种类型:无缓冲、有缓冲
channel有3种模式:写操作模式(单向通道)、读操作模式(单向通道)、读写操作模式(双向通道)
| 写操作模式 | 读操作模式 | 读写操作模式 | |
|---|---|---|---|
| 创建 | make(chan<- int) | make(<-chan int) | make(chan int) |
channel有3种状态:未初始化、正常、关闭
| 未初始化 | 关闭 | 正常 | |
|---|---|---|---|
| 关闭 | panic | panic | 正常关闭 |
| 发送 | 永远阻塞导致死锁 | panic | 阻塞或者成功发送 |
| 接收 | 永远阻塞导致死锁 | 缓冲区为空则为零值, 否则可以继续读 | 阻塞或者成功接收 |
注意点:
- 一个 channel不能多次关闭,会导致painc
- 如果多个 goroutine 都监听同一个 channel,那么 channel 上的数据都可能随机被某一个 goroutine 取走进行消费
- 如果多个 goroutine 监听同一个 channel,如果这个 channel 被关闭,则所有 goroutine 都能收到退出信号
Go channel的底层实现原理?
底层结构需要描述出来,这个简单,buf,发送队列,接收队列,lock。
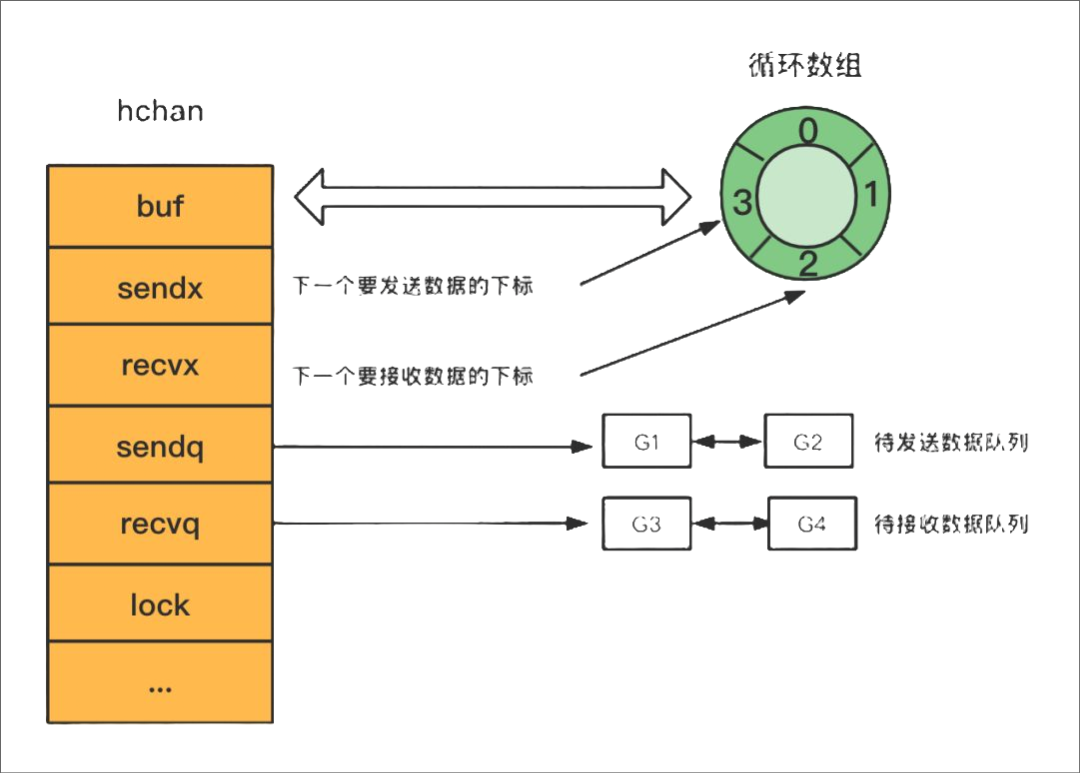
发送
向 channel 中发送数据时大概分为两大块:检查和数据发送,数据发送流程如下:
- 如果 channel 的读等待队列存在接收者goroutine
- 将数据直接发送给第一个等待的 goroutine, 唤醒接收的 goroutine
- 如果 channel 的读等待队列不存在接收者goroutine
- 如果循环数组buf未满,那么将会把数据发送到循环数组buf的队尾
- 如果循环数组buf已满,这个时候就会走阻塞发送的流程,将当前 goroutine 加入写等待队列,并挂起等待唤醒
接收
向 channel 中接收数据时大概分为两大块,检查和数据发送,而数据接收流程如下:
- 如果 channel 的写等待队列存在发送者goroutine
- 如果是无缓冲 channel,直接从第一个发送者goroutine那里把数据拷贝给接收变量,唤醒发送的 goroutine
- 如果是有缓冲 channel(已满),将循环数组buf的队首元素拷贝给接收变量,将第一个发送者goroutine的数据拷贝到 buf循环数组队尾,唤醒发送的 goroutine
- 如果 channel 的写等待队列不存在发送者goroutine
- 如果循环数组buf非空,将循环数组buf的队首元素拷贝给接收变量
- 如果循环数组buf为空,这个时候就会走阻塞接收的流程,将当前 goroutine 加入读等待队列,并挂起等待唤醒
总结hchan结构体的主要组成部分有四个:
- 用来保存goroutine之间传递数据的循环数组:buf
- 用来记录此循环数组当前发送或接收数据的下标值:sendx和recvx
- 用于保存向该chan发送和从该chan接收数据被阻塞的goroutine队列: sendq 和 recvq
- 保证channel写入和读取数据时线程安全的锁:lock
使用场景: 消息传递、消息过滤,信号广播,事件订阅与广播,请求、响应转发,任务分发,结果汇总,并发控制,限流,同步与异步
Go channel有无缓冲的区别?
| 无缓冲 | 有缓冲 | |
|---|---|---|
| 创建方式 | make(chan TYPE) | make(chan TYPE, SIZE) |
| 发送阻塞 | 数据接收前发送阻塞 | 缓冲满时发送阻塞 |
| 接收阻塞 | 数据发送前接收阻塞 | 缓冲空时接收阻塞 |
Go channel为什么是线程安全的?
为什么设计成线程安全?
不同协程通过channel进行通信,本身的使用场景就是多线程,为了保证数据的一致性,必须实现线程安全
如何实现线程安全的?
channel的底层实现中,hchan结构体中采用Mutex锁来保证数据读写安全。在对循环数组buf中的数据进行入队和出队操作时,必须先获取互斥锁,才能操作channel数据
Map
map的底层实现原理

Go中的map是一个指针,占用8个字节,指向hmap结构体
源码包中src/runtime/map.go定义了hmap的数据结构:
hmap包含若干个结构为bmap的数组,每个bmap底层都采用链表结构,bmap通常叫其bucket
hmap结构体
// A header for a Go map.
type hmap struct {
  count     int
  // 代表哈希表中的元素个数,调用len(map)时,返回的就是该字段值。
  flags     uint8
  // 状态标志(是否处于正在写入的状态等)
  B         uint8
  // buckets(桶)的对数
  // 如果B=5,则buckets数组的长度 = 2^B=32,意味着有32个桶
  noverflow uint16
  // 溢出桶的数量
  hash0     uint32
  // 生成hash的随机数种子
  buckets    unsafe.Pointer
  // 指向buckets数组的指针,数组大小为2^B,如果元素个数为0,它为nil。
  oldbuckets unsafe.Pointer
  // 如果发生扩容,oldbuckets是指向老的buckets数组的指针,老的buckets数组大小是新的buckets的1/2;非扩容状态下,它为nil。
  nevacuate  uintptr
  // 表示扩容进度,小于此地址的buckets代表已搬迁完成。
  extra *mapextra
  // 存储溢出桶,这个字段是为了优化GC扫描而设计的,下面详细介绍
}
bmap结构体
bmap 就是我们常说的“桶”,一个桶里面会最多装 8 个 key,这些 key 之所以会落入同一个桶,是因为它们经过哈希计算后,哈希结果的低B位是相同的,关于key的定位我们在map的查询中详细说明。在桶内,又会 根据 key 计算出来的 hash 值的高 8 位来决定 key 到底落入桶内的哪个位置(一个桶内最多有8个位置)。
// A bucket for a Go map.
type bmap struct {
  tophash [bucketCnt]uint8
  // len为8的数组
  // 用来快速定位key是否在这个bmap中
  // 一个桶最多8个槽位,如果key所在的tophash值在tophash中,则代表该key在这个桶中
}
上面bmap结构是静态结构,在编译过程中runtime.bmap会拓展成以下结构体:
type bmap struct{
tophash [8]uint8
keys [8]keytype
// keytype 由编译器编译时候确定
values [8]elemtype
// elemtype 由编译器编译时候确定
overflow uintptr
// overflow指向下一个bmap,overflow是uintptr而不是*bmap类型,保证bmap完全不含指针,是为了减少gc,溢出桶存储到extra字段中
}
tophash就是用于实现快速定位key的位置,在实现过程中会使用key的hash值的高8位作为tophash值,存放在bmap的tophash字段中
tophash字段不仅存储key哈希值的高8位,还会存储一些状态值,用来表明当前桶单元状态,这些状态值都是小于minTopHash的
为了避免key哈希值的高8位值和这些状态值相等,产生混淆情况,所以当key哈希值高8位若小于minTopHash时候,自动将其值加上minTopHash作为该key的tophash。桶单元的状态值如下:
emptyRest      = 0 // 表明此桶单元为空,且更高索引的单元也是空
emptyOne       = 1 // 表明此桶单元为空
evacuatedX     = 2 // 用于表示扩容迁移到新桶前半段区间
evacuatedY     = 3 // 用于表示扩容迁移到新桶后半段区间
evacuatedEmpty = 4 // 用于表示此单元已迁移
minTopHash     = 5 // key的tophash值与桶状态值分割线值,小于此值的一定代表着桶单元的状态,大于此值的一定是key对应的tophash值

func tophash(hash uintptr) uint8 {
top := uint8(hash >> (goarch.PtrSize*8 - 8))
if top < minTopHash {
top += minTopHash
}
return top
}
mapextra结构体
当map的key和value都不是指针类型时候,bmap将完全不包含指针,那么gc时候就不用扫描bmap。bmap指向溢出桶的字段overflow是uintptr类型,为了防止这些overflow桶被gc掉,所以需要mapextra.overflow将它保存起来。如果bmap的overflow是*bmap类型,那么gc扫描的是一个个拉链表,效率明显不如直接扫描一段内存(hmap.mapextra.overflow)
type mapextra struct {
overflow    *[]*bmap
// overflow 包含的是 hmap.buckets 的 overflow 的 buckets
oldoverflow *[]*bma
// oldoverflow 包含扩容时 hmap.oldbuckets 的 overflow 的 bucket
nextOverflow *bmap
// 指向空闲的 overflow bucket 的指针
}
总结
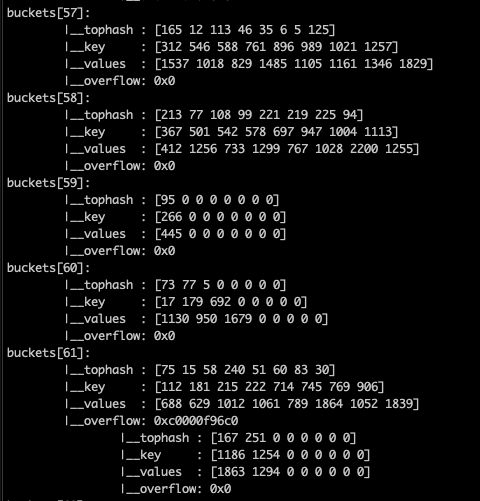
bmap(bucket)内存数据结构可视化如下:
注意到 key 和 value 是各自放在一起的,并不是 key/value/key/value/... 这样的形式,当key和value类型不一样的时候,key和value占用字节大小不一样,使用key/value这种形式可能会因为内存对齐导致内存空间浪费,所以Go采用key和value分开存储的设计,更节省内存空间
Go map如何查找?
Go 语言中读取 map 有两种语法:带 comma 和 不带 comma。当要查询的 key 不在 map 里,带 comma 的用法会返回一个 bool 型变量提示 key 是否在 map 中;而不带 comma 的语句则会返回一个 value 类型的零值。如果 value 是 int 型就会返回 0,如果 value 是 string 类型,就会返回空字符串。
// 不带 comma 用法
value := m["name"]
fmt.Printf("value:%s", value)

// 带 comma 用法
value, ok := m["name"]
if ok {
fmt.Printf("value:%s", value)
}
map的查找通过生成汇编码可以知道,根据 key 的不同类型/返回参数,编译器会将查找函数用更具体的函数替换,以优化效率:
| key 类型 | 查找 |
|---|---|
| uint32 | mapaccess1_fast32(t maptype, h hmap, key uint32) unsafe.Pointer |
| uint32 | mapaccess2_fast32(t maptype, h hmap, key uint32) (unsafe.Pointer, bool) |
| uint64 | mapaccess1_fast64(t maptype, h hmap, key uint64) unsafe.Pointer |
| uint64 | mapaccess2_fast64(t maptype, h hmap, key uint64) (unsafe.Pointer, bool) |
| string | mapaccess1_faststr(t maptype, h hmap, ky string) unsafe.Pointer |
| string | mapaccess2_faststr(t maptype, h hmap, ky string) (unsafe.Pointer, bool) |
查找流程
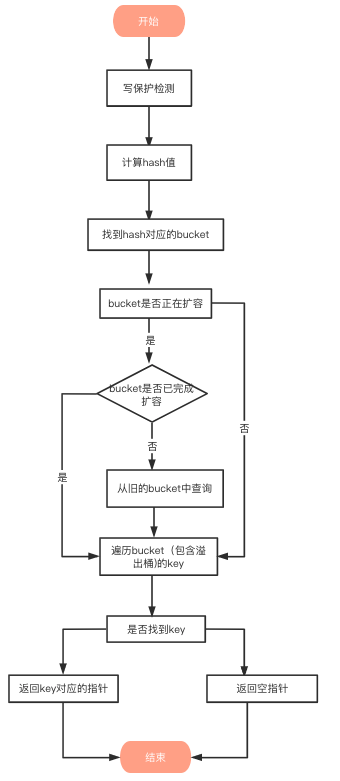
- 写保护监测
函数首先会检查 map 的标志位 flags。如果 flags 的写标志位此时被置 1 了,说明有其他协程在执行“写”操作,进而导致程序 panic,这也说明了 map 不是线程安全的
if h.flags&hashWriting != 0 {
    throw("concurrent map read and map write")
}
- 计算hash值
hash := t.hasher(key, uintptr(h.hash0))
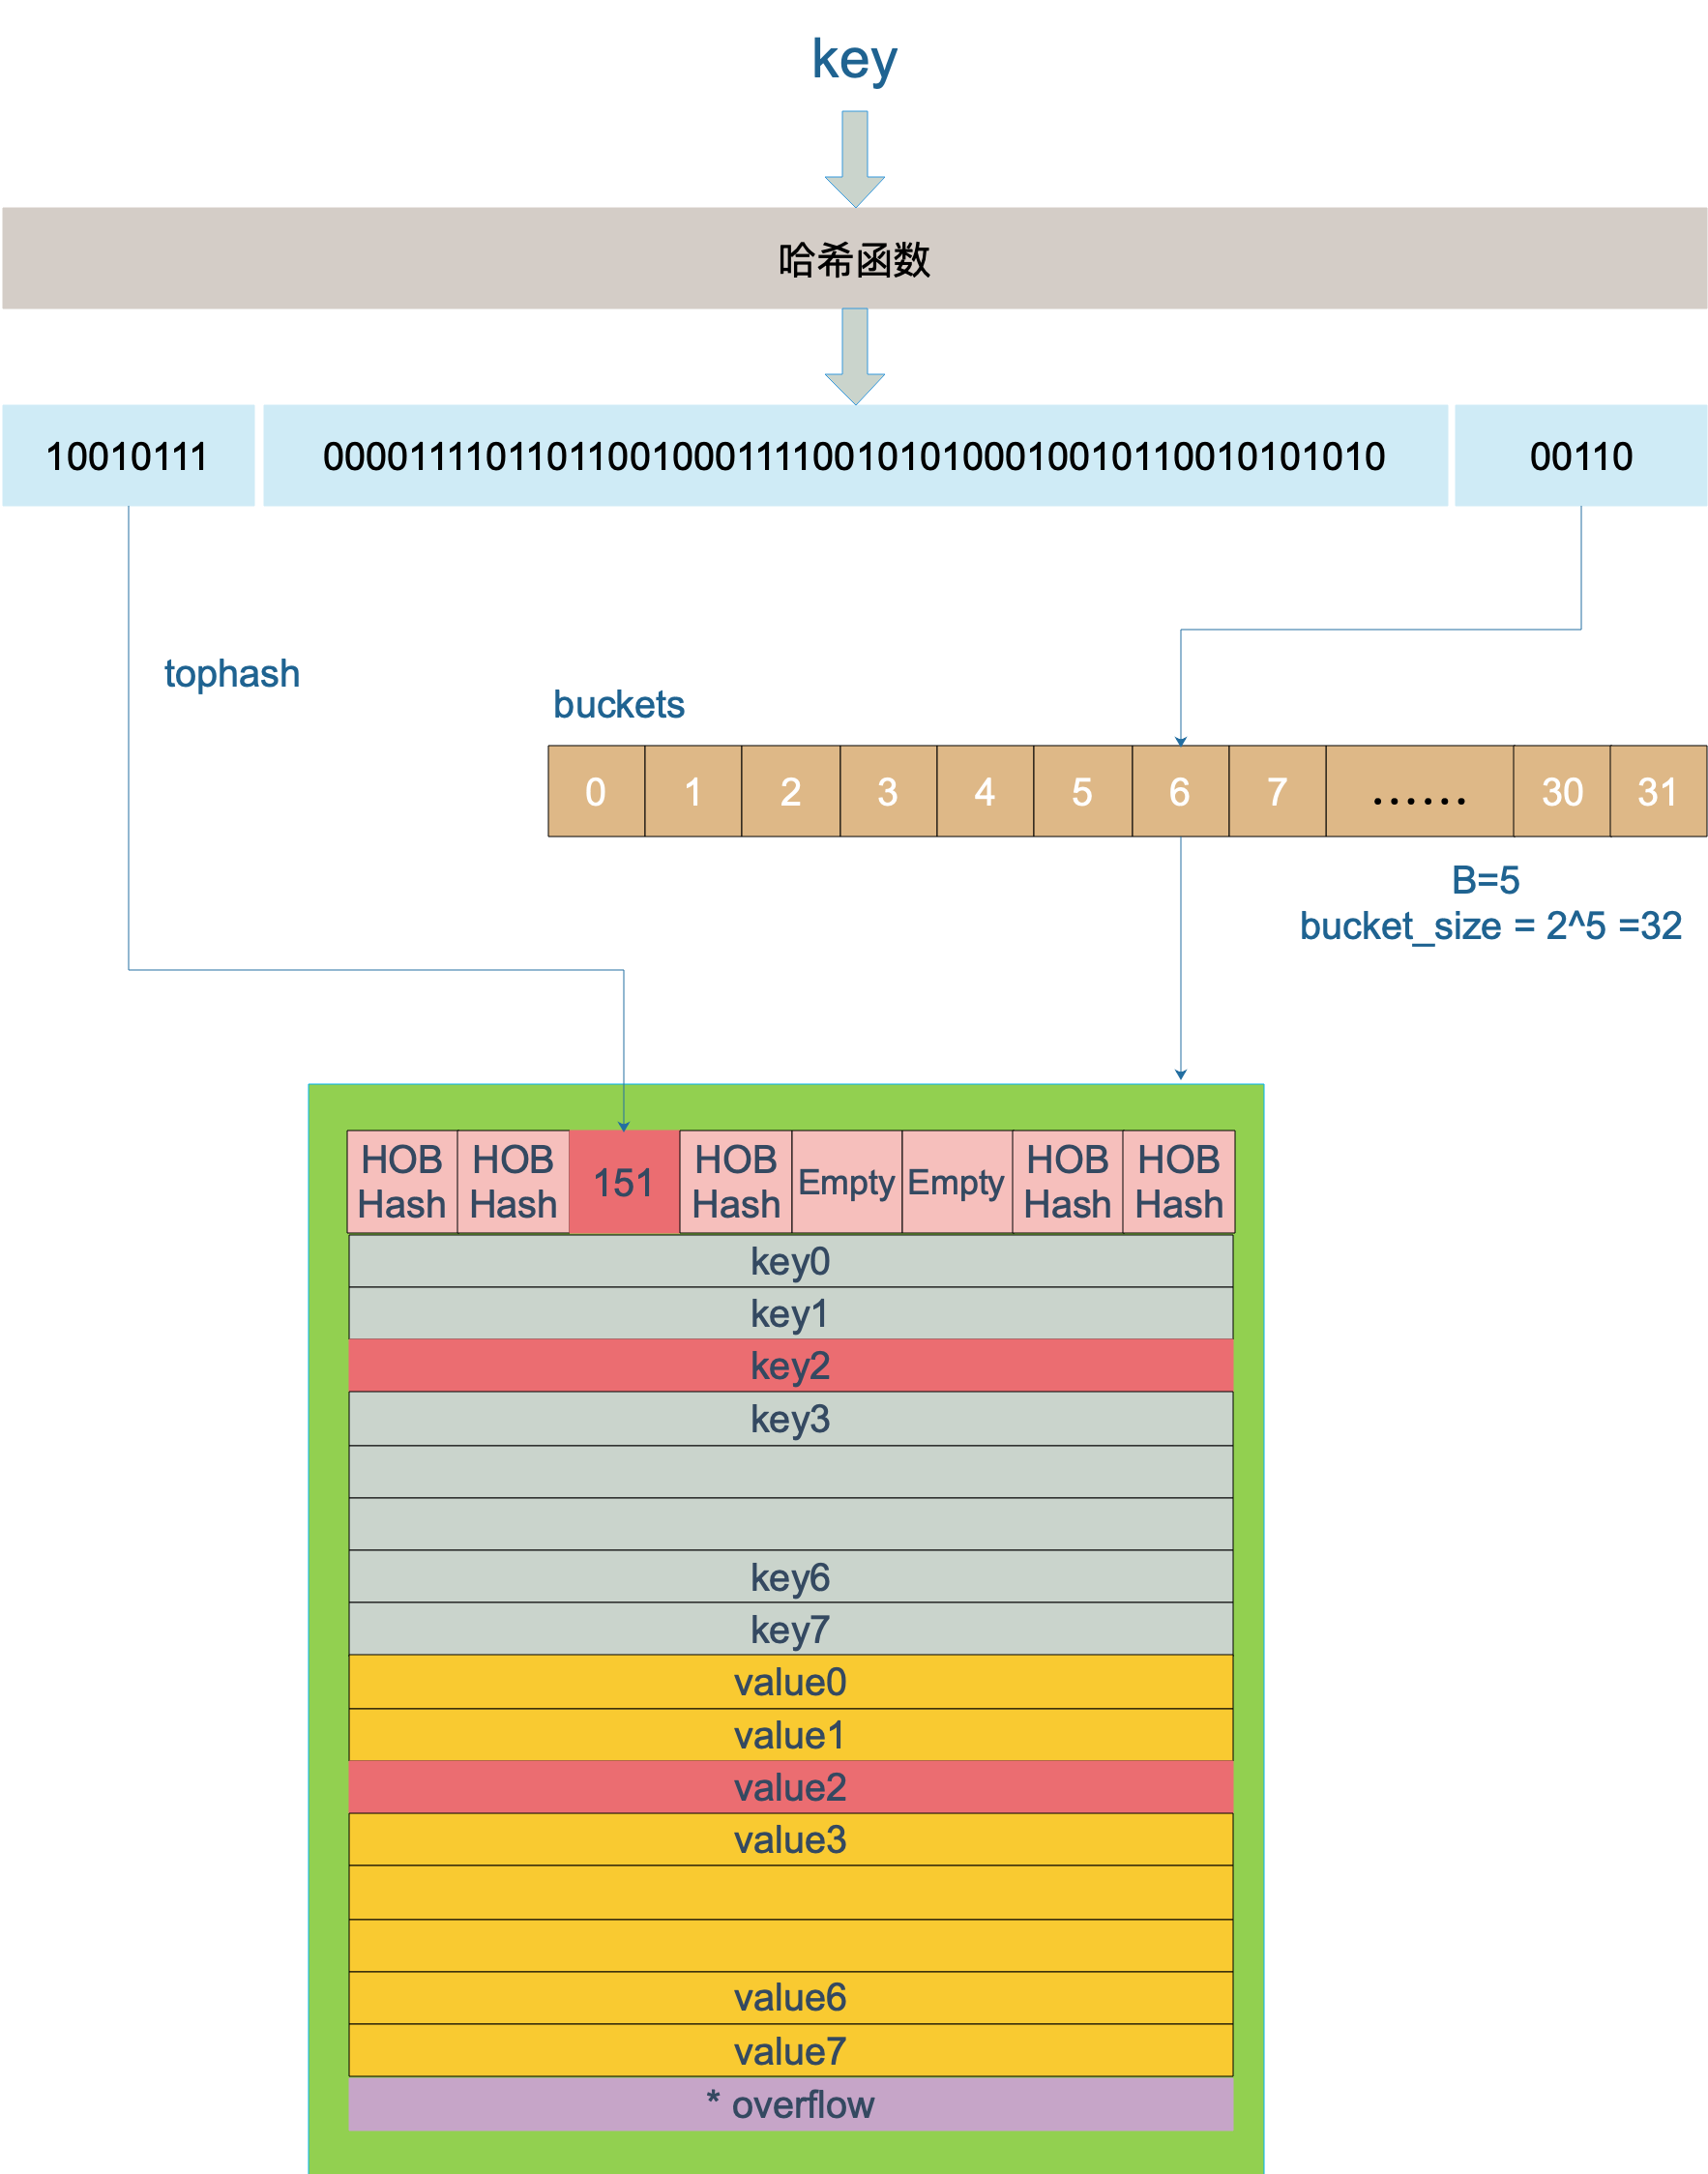
key经过哈希函数计算后,得到的哈希值如下(主流64位机下共 64 个 bit 位), 不同类型的key会有不同的hash函数
10010111 | 000011110110110010001111001010100010010110010101010 │ 01010
- 找到hash对应的bucket
bucket定位:哈希值的低B个bit 位,用来定位key所存放的bucket
如果当前正在扩容中,并且定位到的旧bucket数据还未完成迁移,则使用旧的bucket(扩容前的bucket)
hash := t.hasher(key, uintptr(h.hash0))
    // 桶的个数m-1,即 1<<B-1,B=5时,则有0~31号桶
    m := bucketMask(h.B)
    // 计算哈希值对应的bucket
    // t.bucketsize为一个bmap的大小,通过对哈希值和桶个数取模得到桶编号,通过对桶编号和buckets起始地址进行运算,获取哈希值对应的bucket
    b := (*bmap)(add(h.buckets, (hash&m)*uintptr(t.bucketsize)))
    // 是否在扩容
    if c := h.oldbuckets; c != nil {
        // 桶个数已经发生增长一倍,则旧bucket的桶个数为当前桶个数的一半
        if !h.sameSizeGrow() {
            // There used to be half as many buckets; mask down one more power of two.
            m >>= 1
        }
        // 计算哈希值对应的旧bucket
        oldb := (*bmap)(add(c, (hash&m)*uintptr(t.bucketsize)))
        // 如果旧bucket的数据没有完成迁移,则使用旧bucket查找
        if !evacuated(oldb) {
            b = oldb
        }
    }
4. 遍历bucket查找
tophash值定位:哈希值的高8个bit 位,用来快速判断key是否已在当前bucket中(如果不在的话,需要去bucket的overflow中查找)
用步骤2中的hash值,得到高8个bit位,也就是10010111,转化为十进制,也就是151
    top := tophash(hash)
        func tophash(hash uintptr) uint8 {
        top := uint8(hash >> (goarch.PtrSize*8 - 8))
        if top < minTopHash {
        top += minTopHash
    }
        return top
    }
上面函数中hash是64位的,sys.PtrSize值是8,所以top := uint8(hash >> (sys.PtrSize*8 - 8))等效top = uint8(hash >> 56),最后top取出来的值就是hash的高8位值
在 bucket 及bucket的overflow中寻找tophash 值(HOB hash)为 151 的 槽位,即为key所在位置,找到了空槽位或者 2 号槽位,这样整个查找过程就结束了,其中找到空槽位代表没找到。
for ; b != nil; b = b.overflow(t) {
        for i := uintptr(0); i < bucketCnt; i++ {
            if b.tophash[i] != top {
                // 未被使用的槽位,插入
                if b.tophash[i] == emptyRest {
                    break bucketloop
                }
                continue
            }
            // 找到tophash值对应的的key
            k := add(unsafe.Pointer(b), dataOffset+i*uintptr(t.keysize))
            if t.key.equal(key, k) {
                e := add(unsafe.Pointer(b), dataOffset+bucketCnt*uintptr(t.keysize)+i*uintptr(t.elemsize))
                return e
            }
        }
    }
5. 返回key对应的指针
如果通过上面的步骤找到了key对应的槽位下标 i,我们再详细分析下key/value值是如何获取的:
// keys的偏移量
dataOffset = unsafe.Offsetof(struct{
b bmap
v int64
}{}.v)

// 一个bucket的元素个数
bucketCnt = 8

// key 定位公式
k :=add(unsafe.Pointer(b),dataOffset+i*uintptr(t.keysize))

// value 定位公式
v:= add(unsafe.Pointer(b),dataOffset+bucketCnt*uintptr(t.keysize)+i*uintptr(t.valuesize))
bucket 里 keys 的起始地址就是 unsafe.Pointer(b)+dataOffset
第 i 个下标 key 的地址就要在此基础上跨过 i 个 key 的大小;
而我们又知道,value 的地址是在所有 key 之后,因此第 i 个下标 value 的地址还需要加上所有 key 的偏移。
map如何扩容?
扩容时机:
在向 map 插入新 key 的时候,会进行条件检测,符合下面这 2 个条件,就会触发扩容
if !h.growing() && (overLoadFactor(h.count+1, h.B) || tooManyOverflowBuckets(h.noverflow, h.B)) {
hashGrow(t, h)
goto again // Growing the table invalidates everything, so try again
}

// 判断是否在扩容
func (h *hmap) growing() bool {
return h.oldbuckets != nil
}
扩容条件:
条件1:超过负载
map元素个数 > 6.5 * 桶个数
func overLoadFactor(count int, B uint8) bool {
return count > bucketCnt && uintptr(count) > loadFactor*bucketShift(B)
}

其中
bucketCnt = 8,一个桶可以装的最大元素个数
loadFactor = 6.5,负载因子,平均每个桶的元素个数
bucketShift(B): 桶的个数
条件2:溢出桶太多
当桶总数 < 2 ^ 15 时,如果溢出桶总数 >= 桶总数,则认为溢出桶过多。
当桶总数 >= 2 ^ 15 时,直接与 2 ^ 15 比较,当溢出桶总数 >= 2 ^ 15 时,即认为溢出桶太多了。
func tooManyOverflowBuckets(noverflow uint16, B uint8) bool {
// If the threshold is too low, we do extraneous work.
// If the threshold is too high, maps that grow and shrink can hold on to lots of unused memory.
// "too many" means (approximately) as many overflow buckets as regular buckets.
// See incrnoverflow for more details.
if B > 15 {
B = 15
}
// The compiler does not see here that B < 16; mask B to generate shorter shift code.
return noverflow >= uint16(1)<<(B&15)
}
对于条件2,其实算是对条件1的补充。因为在负载因子比较小的情况下,有可能 map 的查找和插入效率也很低,而第 1 点识别不出来这种情况。
表面现象就是负载因子比较小比较小,即 map 里元素总数少,但是桶数量多(真实分配的桶数量多,包括大量的溢出桶)。比如不断的增删,这样会造成overflow的bucket数量增多,但负载因子又不高,达不到第 1 点的临界值,就不能触发扩容来缓解这种情况。这样会造成桶的使用率不高,值存储得比较稀疏,查找插入效率会变得非常低,因此有了第 2 扩容条件。
扩容机制:
双倍扩容:针对条件1,新建一个buckets数组,新的buckets大小是原来的2倍,然后旧buckets数据搬迁到新的buckets。该方法我们称之为双倍扩容
**等量扩容:针对条件2,并不扩大容量,buckets数量维持不变,重新做一遍类似双倍扩容的搬迁动作,把松散的键值对重新排列一次,使得同一个 bucket 中的 key 排列地更紧密,节省空间,提高 bucket 利用率,进而保证更快的存取。该方法我们称之为**等量扩容**。
扩容函数:
上面说的 hashGrow() 函数实际上并没有真正地“搬迁”,它只是分配好了新的 buckets,并将老的 buckets 挂到了 oldbuckets 字段上。真正搬迁 buckets 的动作在 growWork() 函数中,而调用 growWork() 函数的动作是在 mapassign 和 mapdelete 函数中。也就是插入或修改、删除 key 的时候,都会尝试进行搬迁 buckets 的工作。先检查 oldbuckets 是否搬迁完毕,具体来说就是检查 oldbuckets 是否为 nil
1  func hashGrow(t *maptype, h *hmap) {
2  // 如果达到条件 1,那么将B值加1,相当于是原来的2倍
3  // 否则对应条件 2,进行等量扩容,所以 B 不变
4    bigger := uint8(1)
5    if !overLoadFactor(h.count+1, h.B) {
6        bigger = 0
7        h.flags |= sameSizeGrow
8    }
9  // 记录老的buckets
10    oldbuckets := h.buckets
11  // 申请新的buckets空间
12    newbuckets, nextOverflow := makeBucketArray(t, h.B+bigger, nil)
13  // 注意&^ 运算符,这块代码的逻辑是转移标志位
14    flags := h.flags &^ (iterator | oldIterator)
15    if h.flags&iterator != 0 {
16        flags |= oldIterator
17    }
18    // 提交grow (atomic wrt gc)
19    h.B += bigger
20    h.flags = flags
21    h.oldbuckets = oldbuckets
22    h.buckets = newbuckets
23  // 搬迁进度为0
24    h.nevacuate = 0
25  // overflow buckets 数为0
26    h.noverflow = 0
27
28  // 如果发现hmap是通过extra字段 来存储 overflow buckets时
29    if h.extra != nil && h.extra.overflow != nil {
30        if h.extra.oldoverflow != nil {
31            throw("oldoverflow is not nil")
32        }
33        h.extra.oldoverflow = h.extra.overflow
34        h.extra.overflow = nil
35    }
36    if nextOverflow != nil {
37        if h.extra == nil {
38            h.extra = new(mapextra)
39        }
40        h.extra.nextOverflow = nextOverflow
41    }
42}
由于 map 扩容需要将原有的 key/value 重新搬迁到新的内存地址,如果map存储了数以亿计的key-value,一次性搬迁将会造成比较大的延时,因此 Go map 的扩容采取了一种称为“渐进式”的方式,原有的 key 并不会一次性搬迁完毕,每次最多只会搬迁 2 个 bucket。
func growWork(t *maptype, h *hmap, bucket uintptr) {
    // 为了确认搬迁的 bucket 是我们正在使用的 bucket
    // 即如果当前key映射到老的bucket1,那么就搬迁该bucket1。
    evacuate(t, h, bucket&h.oldbucketmask())
    // 如果还未完成扩容工作,则再搬迁一个bucket。
    if h.growing() {
        evacuate(t, h, h.nevacuate)
    }
}
map中删除一个 key 它的内存会释放么
- 如果删除的元素是值类型,如int,float,bool,string以及数组和struct,map的内存不会自动释放
- 如果删除的元素是引用类型,如指针,slice,map,chan等,map的内存会自动释放,但释放的内存是子元素应用类型的内存占用
- 将map设置为nil后,内存被回收
nil map和空map有何不同?
1)可以对未初始化的map进行取值,但取出来的东西是空:
var m1 map[string]string
fmt.Println(m1[“1”])
2)不能对未初始化的map进行赋值,这样将会抛出一个异常:
var m1 map[string]string
m1[“1”] = “1”
panic: assignment to entry in nil map
3)通过fmt打印map时,空map和nil map结果是一样的,都为map[]。所以,这个时候别断定map是空还是nil,而应该通过map == nil来判断。
nil map 未初始化,空map是长度为空
slices能作为map类型的key吗?
当时被问的一脸懵逼,其实是这个问题的变种:golang 哪些类型可以作为map key?
答案是:在golang规范中,可比较的类型都可以作为map key;这个问题又延伸到在:golang规范中,哪些数据类型可以比较?
不能作为map key 的类型包括:
- slices
- maps
- functions
GMP
什么是 GMP?
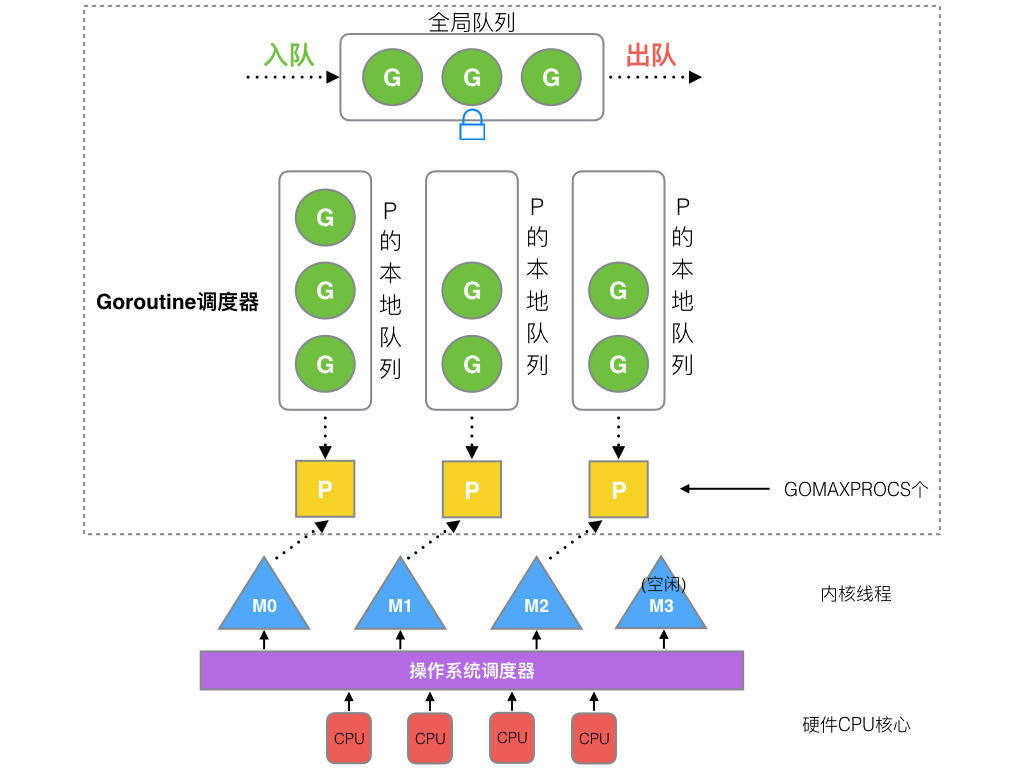
1、我们通过 go func () 来创建一个 goroutine;
2、有两个存储 G 的队列,一个是局部调度器 P 的本地队列、一个是全局 G 队列。新创建的 G 会先保存在 P 的本地队列中,如果 P 的本地队列已经满了就会保存在全局的队列中;
3、G 只能运行在 M 中,一个 M 必须持有一个 P,M 与 P 是 1:1 的关系。M 会从 P 的本地队列弹出一个可执行状态的 G 来执行,如果 P 的本地队列为空,就会想其他的 MP 组合偷取一个可执行的 G 来执行 这种从其它P偷的方式称之为 work stealing;
4、一个 M 调度 G 执行的过程是一个循环机制;
5、- 如果 M在执行 G 的过程发生系统调用阻塞(同步),会阻塞G和M(操作系统限制),此时P会和当前M解绑,并寻找新的M,如果没有空闲的M就会新建一个M ,接管正在阻塞G所属的P,接着继续执行 P中其余的G,这种阻塞后释放P的方式称之为hand off。当系统调用结束后,这个G会尝试获取一个空闲的P执行,优先获取之前绑定的P,并放入到这个P的本地队列,如果获取不到P,那么这个线程M变成休眠状态,加入到空闲线程中,然后这个G会被放入到全局队列中。
如果M在执行G的过程发生网络IO等操作阻塞时(异步),阻塞G,不会阻塞M。M会寻找P中其它可执行的G继续执行,G会被网络轮询器network poller 接手,当阻塞的G恢复后,G1从network poller 被移回到P的 LRQ 中,重新进入可执行状态。异步情况下,通过调度,Go scheduler 成功地将 I/O 的任务转变成了 CPU 任务,或者说将内核级别的线程切换转变成了用户级别的 goroutine 切换,大大提高了效率。
6、当 M 系统调用结束时候,这个 G 会尝试获取一个空闲的 P 执行,并放入到这个 P 的本地队列。如果获取不到 P,那么这个线程 M 变成休眠状态, 加入到空闲线程中,然后这个 G 会被放入全局队列中。
work stealing 机制?
窃取流程
源码见runtime/proc.go stealWork函数,窃取流程如下,如果经过多次努力一直找不到需要运行的goroutine则调用stopm进入睡眠状态,等待被其它工作线程唤醒。
- 选择要窃取的P
- 从P中偷走一半G(向下取整)
选择要窃取的P
窃取的实质就是遍历allp中的所有p,查看其运行队列是否有goroutine,如果有,则取其一半到当前工作线程的运行队列
为了保证公平性,遍历allp时并不是固定的从allp[0]即第一个p开始,而是从随机位置上的p开始,而且遍历的顺序也随机化了,并不是现在访问了第i个p下一次就访问第i+1个p,而是使用了一种伪随机的方式遍历allp中的每个p,防止每次遍历时使用同样的顺序访问allp中的元素
从P中偷走一半G
源码见runtime/proc.go runqsteal函数:
挑选出盗取的对象p之后,则调用runqsteal盗取p的运行队列中的goroutine,runqsteal函数再调用runqgrap从p的本地队列尾部批量偷走一半的g
为啥是偷一半的g,可以理解为负载均衡
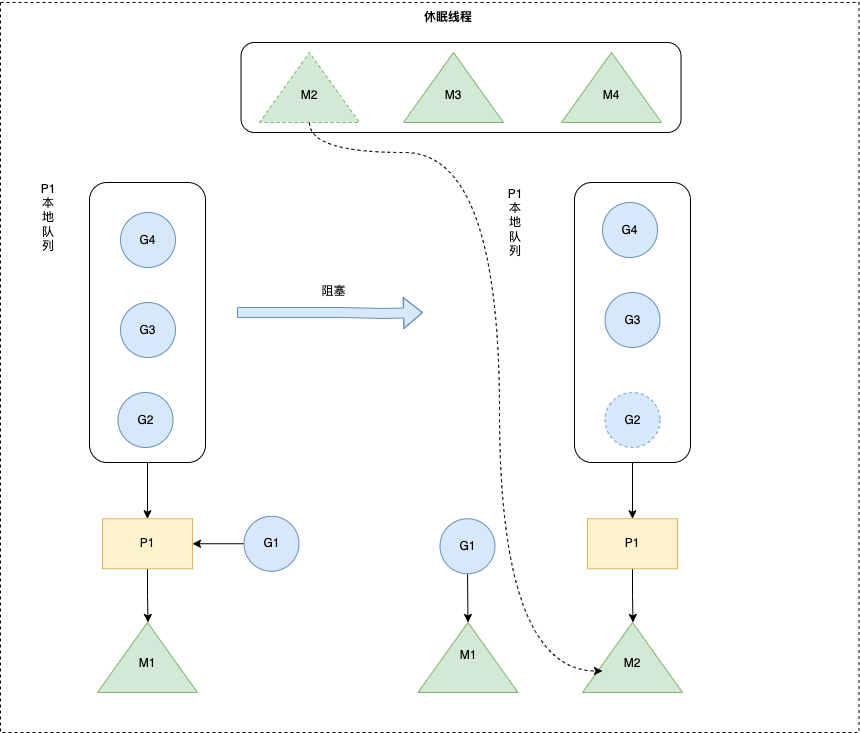
hand off 机制
也称为P分离机制,当本线程 M 因为 G 进行的系统调用阻塞时,线程释放绑定的 P,把 P 转移给其他空闲的 M 执行,也提高了线程利用率(避免站着茅坑不拉shi)。
当前线程M阻塞时,释放P,给其它空闲的M处理
抢占式调度是如何抢占的?
在1.2版本之前,Go的调度器仍然不支持抢占式调度,程序只能依靠Goroutine主动让出CPU资源才能触发调度,这会引发一些问题,比如:
- 某些 Goroutine 可以长时间占用线程,造成其它 Goroutine 的饥饿
- 垃圾回收器是需要stop the world的,如果垃圾回收器想要运行了,那么它必须先通知其它的goroutine停下来,这会造成较长时间的等待时间
为解决这个问题:
- Go 1.2 中实现了基于协作的“抢占式”调度
- Go 1.14 中实现了基于信号的“抢占式”调度
基于协作的抢占式调度
协作式:大家都按事先定义好的规则来,比如:一个goroutine执行完后,退出,让出p,然后下一个goroutine被调度到p上运行。这样做的缺点就在于 是否让出p的决定权在groutine自身。一旦某个g不主动让出p或执行时间较长,那么后面的goroutine只能等着,没有方法让前者让出p,导致延迟甚至饿死。
非协作式: 就是由runtime来决定一个goroutine运行多长时间,如果你不主动让出,对不起,我有手段可以抢占你,把你踢出去,让后面的goroutine进来运行。
基于协作的抢占式调度流程:
- 编译器会在调用函数前插入 runtime.morestack,让运行时有机会在这段代码中检查是否需要执行抢占调度
- Go语言运行时会在垃圾回收暂停程序、系统监控发现 Goroutine 运行超过 10ms,那么会在这个协程设置一个抢占标记
- 当发生函数调用时,可能会执行编译器插入的 runtime.morestack,它调用的 runtime.newstack会检查抢占标记,如果有抢占标记就会触发抢占让出cpu,切到调度主协程里
这种解决方案只能说局部解决了“饿死”问题,只在有函数调用的地方才能插入“抢占”代码(埋点),对于没有函数调用而是纯算法循环计算的 G,Go 调度器依然无法抢占。
比如,死循环等并没有给编译器插入抢占代码的机会,以下程序在 go 1.14 之前的 go版本中,运行后会一直卡住,而不会打印 I got scheduled!
func main() {
    runtime.GOMAXPROCS(1) //P 的数量
    go func() {
        for {
        }
    }()

    time.Sleep(time.Second)
    fmt.Println("I got scheduled!")
}
为了解决这些问题,Go 在 1.14 版本中增加了对非协作的抢占式调度的支持,这种抢占式调度是基于系统信号的,也就是通过向线程发送信号的方式来抢占正在运行的 Goroutine
基于信号的抢占式调度
真正的抢占式调度是基于信号完成的,所以也称为“异步抢占”。不管协程有没有意愿主动让出 cpu 运行权,只要某个协程执行时间过长,就会发送信号强行夺取 cpu 运行权。
- M 注册一个 SIGURG 信号的处理函数:sighandler
- sysmon启动后会间隔性的进行监控,最长间隔10ms,最短间隔20us。如果发现某协程独占P超过10ms,会给M发送抢占信号
- M 收到信号后,内核执行 sighandler 函数把当前协程的状态从_Grunning正在执行改成 _Grunnable可执行,把抢占的协程放到全局队列里,M继续寻找其他 goroutine 来运行
- 被抢占的 G 再次调度过来执行时,会继续原来的执行流
抢占分为_Prunning和_Psyscall,_Psyscall抢占通常是由于阻塞性系统调用引起的,比如磁盘io、cgo。_Prunning抢占通常是由于一些类似死循环的计算逻辑引起的。
goroutine
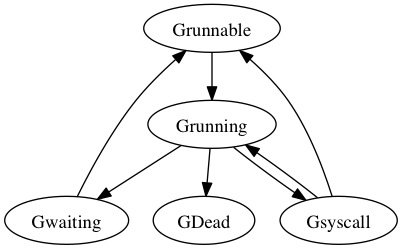
状态流转
| 状态 | 含义 |
|---|---|
| 空闲中_Gidle | G刚刚新建, 仍未初始化 |
| 待运行_Grunnable | 就绪状态,G在运行队列中, 等待M取出并运行 |
| 运行中_Grunning | M正在运行这个G, 这时候M会拥有一个P |
| 系统调用中_Gsyscall | M正在运行这个G发起的系统调用, 这时候M并不拥有P |
| 等待中_Gwaiting | G在等待某些条件完成, 这时候G不在运行也不在运行队列中(可能在channel的等待队列中) |
| 已中止_Gdead | G未被使用, 可能已执行完毕 |
| 栈复制中_Gcopystack | G正在获取一个新的栈空间并把原来的内容复制过去(用于防止GC扫描) |
进程线程协程的区别
线程和进程之间的区别
- 线程是程序执行的最小单位,而进程是操作系统分配资源的最小单位;
- 一个进程由一个或多个线程组成,线程是一个进程中代码的不同执行路线;
- 进程之间相互独立,但同一进程下的各个线程之间共享程序的内存空间(包括代码段、数据集、堆等)及一些进程级的资源(如打开文件和信号),某进程内的线程在其它进程不可见;
- 调度和切换:线程上下文切换比进程上下文切换要快得多
线程和协程之间的区别
- 从占用资源的角度来说:线程大小初始一般为为1M,协程为2KB,可随需要增大
- 线程是由OS内核完成调度,协程是由用户完成
- 切换的开销:线程切换涉及模式切换(从用户态切换到内核态)、16个寄存器、PC、SP…等寄存器的刷新等;协程只有三个寄存器的值修改 - PC / SP / DX.
- 线程资源占用太高,频繁创建销毁会带来严重的性能问题;协程资源占用小,不会带来严重的性能问题
- 在数据的同步上:线程需要用锁等机制确保数据的一致性和可见性;协程不需要多线程的锁机制,因为只有一个线程,也不存在同时写变量冲突,在协程中控制共享资源不加锁,只需要判断状态就好了,所以执行效率比多线程高很多。
进程:是应用程序的启动实例,每个进程都有独立的内存空间,不同的进程通过进程间的通信方式来通信。
线程:从属于进程,每个进程至少包含一个线程,线程是 CPU 调度的基本单位,多个线程之间可以共享进程的资源并通过共享内存等线程间的通信方式来通信。
协程:为轻量级线程,与线程相比,协程不受操作系统的调度,协程的调度器由用户应用程序提供,协程调度器按照调度策略把协程调度到线程中运行
锁
Go 互斥锁的实现原理?
底层实现结构:
互斥锁对应的是底层结构是sync.Mutex结构体,,位于 src/sync/mutex.go中
type Mutex struct {
    state int32
    sema  uint32
}
state表示锁的状态,有锁定、被唤醒、饥饿模式等,并且是用state的二进制位来标识的,不同模式下会有不同的处理方式
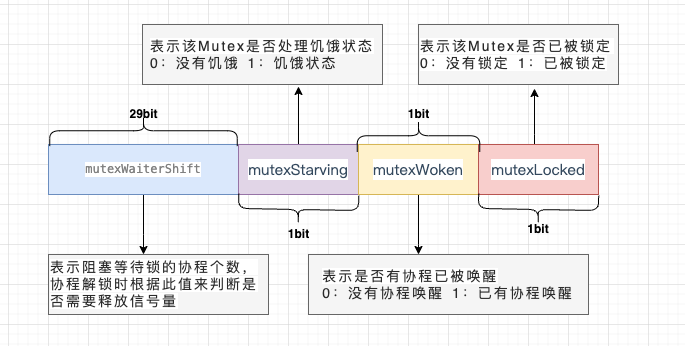
sema表示信号量,mutex阻塞队列的定位是通过这个变量来实现的,从而实现goroutine的阻塞和唤醒
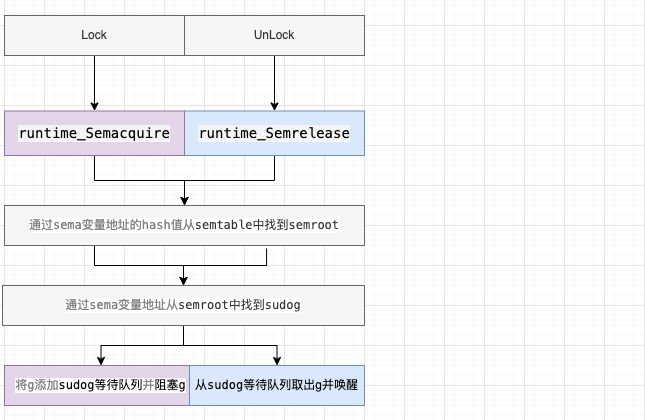
操作:
锁的实现一般会依赖于原子操作、信号量,通过atomic 包中的一些原子操作来实现锁的锁定,通过信号量来实现线程的阻塞与唤醒
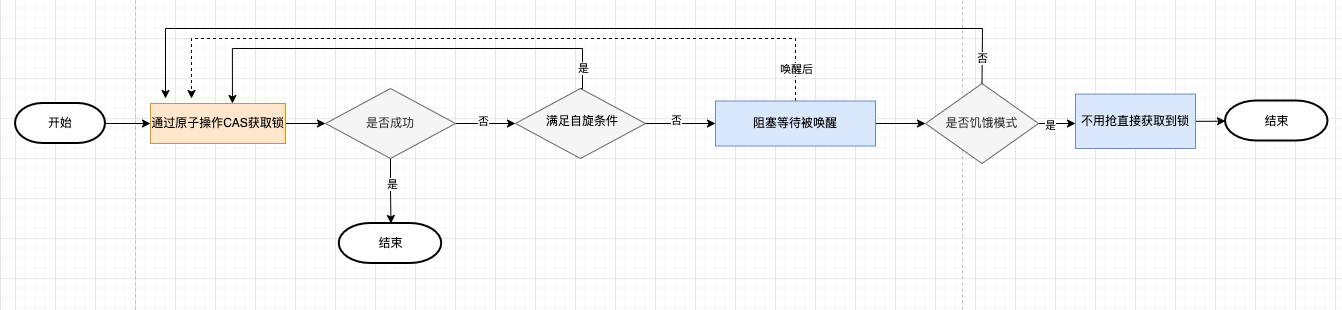
加锁
通过原子操作cas加锁,如果加锁不成功,根据不同的场景选择自旋重试加锁或者阻塞等待被唤醒后加锁
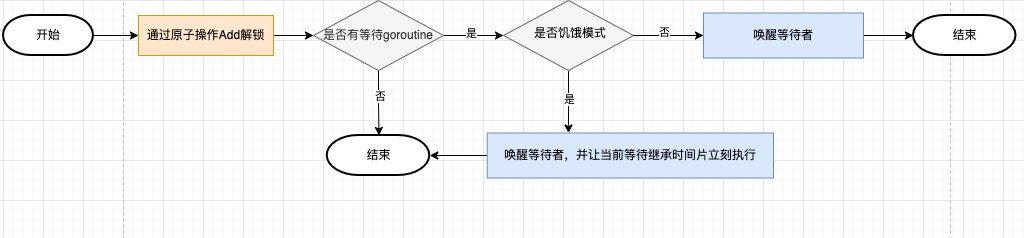
解锁
通过原子操作add解锁,如果仍有goroutine在等待,唤醒等待的goroutine
Mutex 有几种模式?
在Go一共可以分为两种抢锁的模式,一种是正常模式,另外一种是饥饿模式。
正常模式(非公平锁)
在刚开始的时候,是处于正常模式(Barging),也就是,当一个G1持有着一个锁的时候,G2会自旋的去尝试获取这个锁
当自旋超过4次还没有能获取到锁的时候,这个G2就会被加入到获取锁的等待队列里面,并阻塞等待唤醒
正常模式下,所有等待锁的 goroutine 按照 FIFO(先进先出)顺序等待。唤醒的goroutine 不会直接拥有锁,而是会和新请求锁的 goroutine 竞争锁。新请求锁的 goroutine 具有优势:它正在 CPU 上执行,而且可能有好几个,所以刚刚唤醒的 goroutine 有很大可能在锁竞争中失败,长时间获取不到锁,就会切换到饥饿模式
饥饿模式(公平锁)
当一个 goroutine 等待锁时间超过 1 毫秒时,它可能会遇到饥饿问题。 在版本1.9中,这种场景下Go Mutex 切换到饥饿模式(handoff),解决饥饿问题。
starving = runtime_nanotime()-waitStartTime > 1e6
饥饿模式下,直接把锁交给等待队列中排在第一位的goroutine(队头),同时饥饿模式下,新进来的goroutine不会参与抢锁也不会进入自旋状态,会直接进入等待队列的尾部,这样很好的解决了老的goroutine一直抢不到锁的场景。
那么也不可能说永远的保持一个饥饿的状态,总归会有吃饱的时候,也就是总有那么一刻Mutex会回归到正常模式,那么回归正常模式必须具备的条件有以下几种:
1. G的执行时间小于1ms
2. 等待队列已经全部清空了
当满足上述两个条件的任意一个的时候,Mutex会切换回正常模式,而Go的抢锁的过程,就是在这个正常模式和饥饿模式中来回切换进行的。
delta := int32(mutexLocked - 1<<mutexWaiterShift)
if !starving || old>>mutexWaiterShift == 1 {
delta -= mutexStarving
}
atomic.AddInt32(&m.state, delta)
总结
对于两种模式,正常模式下的性能是最好的,goroutine 可以连续多次获取锁,饥饿模式解决了取锁公平的问题,但是性能会下降,其实是性能和公平的 一个平衡模式。
RWMutex 读写锁
读写互斥锁RWMutex,是对Mutex的一个扩展,当一个 goroutine 获得了读锁后,其他 goroutine可以获取读锁,但不能获取写锁;当一个 goroutine 获得了写锁后,其他 goroutine既不能获取读锁也不能获取写锁(只能存在一个写者或多个读者,可以同时读)
使用场景:
读多于写的情况(既保证线程安全,又保证性能不太差)
互斥锁和读写锁的区别:
- 读写锁区分读者和写者,而互斥锁不区分
- 互斥锁同一时间只允许一个线程访问该对象,无论读写;读写锁同一时间内只允许一个写者,但是允许多个读者同时读对象。
可重入锁
概念:
可重入锁又称为递归锁,是指在同一个线程在外层方法获取锁的时候,在进入该线程的内层方法时会自动获取锁,不会因为之前已经获取过还没释放再次加锁导致死锁
为什么Go语言中没有可重入锁?
Mutex 不是可重入的锁。Mutex 的实现中没有记录哪个 goroutine 拥有这把锁。理论上,任何 goroutine 都可以随意地 Unlock 这把锁,所以没办法计算重入条件,并且Mutex 重复Lock会导致死锁。
内存
Go 内存逃逸机制
概念
在一段程序中,每一个函数都会有自己的内存区域存放自己的局部变量、返回地址等,这些内存会由编译器在栈中进行分配,每一个函数都会分配一个栈桢,在函数运行结束后进行销毁,但是有些变量我们想在函数运行结束后仍然使用它,那么就需要把这个变量在堆上分配,这种从”栈”上逃逸到”堆”上的现象就成为内存逃逸。
在栈上分配的地址,一般由系统申请和释放,不会有额外性能的开销,比如函数的入参、局部变量、返回值等。在堆上分配的内存,如果要回收掉,需要进行 GC,那么GC 一定会带来额外的性能开销。编程语言不断优化GC算法,主要目的都是为了减少 GC带来的额外性能开销,变量一旦逃逸会导致性能开销变大。
逃逸机制
编译器会根据变量是否被外部引用来决定是否逃逸:
- 如果函数外部没有引用,则优先放到栈中;
- 如果函数外部存在引用,则必定放到堆中;
- 如果栈上放不下,则必定放到堆上;
逃逸分析也就是由编译器决定哪些变量放在栈,哪些放在堆中,通过编译参数-gcflag=-m可以查看编译过程中的逃逸分析,发生逃逸的几种场景如下:
指针逃逸
package main

func escape1() *int {
    var a int = 1
    return &a
}

func main() {
    escape1()
}
通过go build -gcflags=-m main.go查看逃逸情况:
./main.go:4:6: moved to heap: a
函数返回值为局部变量的指针,函数虽然退出了,但是因为指针的存在,指向的内存不能随着函数结束而回收,因此只能分配在堆上。
栈空间不足
package main

func escape2() {
    s := make([]int, 0, 10000)
    for index, _ := range s {
        s[index] = index
    }
}

func main() {
    escape2()
}
通过go build -gcflags=-m main.go查看逃逸情况:
./main.go:4:11: make([]int, 10000, 10000) escapes to heap
当栈空间足够时,不会发生逃逸,但是当变量过大时,已经完全超过栈空间的大小时,将会发生逃逸到堆上分配内存。局部变量s占用内存过大,编译器会将其分配到堆上
变量大小不确定
package main

func escape3() {
    number := 10
    s := make([]int, number) // 编译期间无法确定slice的长度
    for i := 0; i < len(s); i++ {
        s[i] = i
    }
}

func main() {
    escape3()
}
编译期间无法确定slice的长度,这种情况为了保证内存的安全,编译器也会触发逃逸,在堆上进行分配内存。直接s := make([]int, 10)不会发生逃逸
动态类型
动态类型就是编译期间不确定参数的类型、参数的长度也不确定的情况下就会发生逃逸
空接口 interface{} 可以表示任意的类型,如果函数参数为 interface{},编译期间很难确定其参数的具体类型,也会发生逃逸。
package main

func escape4() {
    fmt.Println(1111)
}

func main() {
    escape4()
}
通过go build -gcflags=-m main.go查看逃逸情况:
./main.go:6:14: 1111 escapes to heap
fmt.Println(a …interface{})函数参数为interface,编译器不确定参数的类型,会将变量分配到堆上
闭包引用对象
package main

func escape5() func() int {
    var i int = 1
    return func() int {
        i++
        return i
    }
}

func main() {
    escape5()
}
通过go build -gcflags=-m main.go查看逃逸情况:
./main.go:4:6: moved to heap: i
闭包函数中局部变量i在后续函数是继续使用的,编译器将其分配到堆上
总结
- 栈上分配内存比在堆中分配内存效率更高
- 栈上分配的内存不需要 GC 处理,而堆需要
- 逃逸分析目的是决定内分配地址是栈还是堆
- 逃逸分析在编译阶段完成
因为无论变量的大小,只要是指针变量都会在堆上分配,所以对于小变量我们还是使用传值效率(而不是传指针)更高一点。
Go GC流程
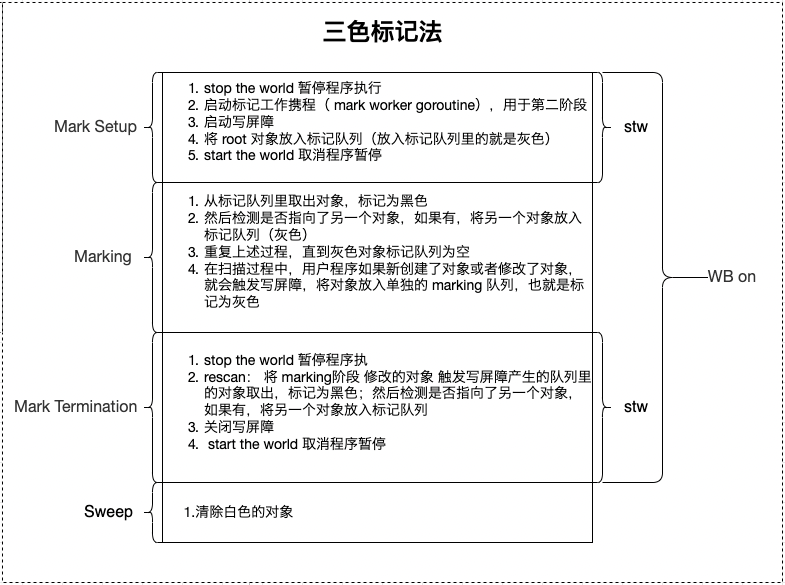
一次完整的垃圾回收会分为四个阶段,分别是标记准备、标记开始、标记终止、清理:
- 标记准备(Mark Setup):打开写屏障(Write Barrier),需 STW(stop the world)
- 标记开始(Marking):使用三色标记法并发标记 ,与用户程序并发执行
- 标记终止(Mark Termination):对触发写屏障的对象进行重新扫描标记,关闭写屏障(Write Barrier),需 STW(stop the world)
- 清理(Sweeping):将需要回收的内存归还到堆中,将过多的内存归还给操作系统,与用户程序并发执行
三色标记法
- 初始状态下所有对象都是白色的。
- 从根节点开始遍历所有对象,把遍历到的root对象变成灰色对象
- 遍历灰色对象,将灰色对象引用的对象也变成灰色对象,然后将遍历过的灰色对象变成黑色对象。
- 循环步骤3,直到灰色对象全部变黑色。
- 通过写屏障(write-barrier)检测对象有变化,重复以上操作
- 写屏障(Write Barrier):上面说到的 STW 的目的是防止 GC 扫描时内存变化引起的混乱,而写屏障就是让 goroutine 与 GC 同时运行的手段,虽然不能完全消除 STW,但是可以大大减少 STW 的时间。写屏障在 GC 的特定时间开启,开启后指针传递时会把指针标记,即本轮不回收,下次 GC 时再确定。
- 辅助 GC(Mutator Assist):为了防止内存分配过快,在 GC 执行过程中,GC 过程中 mutator 线程会并发运行,而 mutator assist 机制会协助 GC 做一部分的工作。
6、收集所有白色对象(垃圾)。
root对象
根对象在垃圾回收的术语中又叫做根集合,它是垃圾回收器在标记过程时最先检查的对象,包括:
全局变量:程序在编译期就能确定的那些存在于程序整个生命周期的变量。
执行栈:每个 goroutine 都包含自己的执行栈,这些执行栈上指向堆内存的指针。
寄存器:寄存器的值可能表示一个指针,参与计算的这些指针可能指向某些赋值器分配的堆内存区块。
插入写屏障
对象被引用时触发的机制(只在堆内存中生效):赋值器这一行为通知给并发执行的回收器,被引用的对象标记为灰色
缺点:结束时需要STW来重新扫描栈,标记栈上引用的白色对象的存活
删除写屏障
对象被删除时触发的机制(只在堆内存中生效):赋值器将这一行为通知给并发执行的回收器,被删除的对象,如果自身为灰色或者白色,那么标记为灰色
缺点:一个对象的引用被删除后,即使没有其他存活的对象引用它,它仍然会活到下一轮,会产生很大冗余扫描成本,且降低了回收精度
混合写屏障
GC没有混合写屏障前,一直是插入写屏障;混合写屏障是插入写屏障 + 删除写屏障,写屏障只应用在堆上应用,栈上不启用(栈上启用成本很高)
- GC开始将栈上的对象全部扫描并标记为黑色。
- GC期间,任何在栈上创建的新对象,均为黑色。
- 被删除的对象标记为灰色。
- 被添加的对象标记为灰色。
内存泄露
是指程序在申请内存后,无法释放已申请的内存空间,一次内存泄露危害可以忽略,但内存泄露堆积后果很严重,无论多少内存,迟早会被占光。
go 中的内存泄漏一般都是 goroutine 泄漏,就是 goroutine 没有被关闭,或者没有添加超时控制,让 goroutine 一只处于阻塞状态,不能被 GC。
互斥锁未释放或者造成死锁会造成内存泄漏
time.Ticker 是每隔指定的时间就会向通道内写数据。作为循环触发器,必须调用 stop 方法才会停止,从而被 GC 掉,否则会一直占用内存空间。
GC 触发机制
GC 的触发情况主要分为两大类,分别是:
- 系统触发:运行时自行根据内置的条件,检查、发现到,则进行 GC 处理,维护整个应用程序的可用性。
- a. 使用系统监控,当超过两分钟没有产生任何GC时,强制触发 GC;
- b.使用步调(Pacing)算法,其核心思想是控制内存增长的比例,当前内存分配达到一定比例则触发
- 手动触发:开发者在业务代码中自行调用 runtime.GC 方法来触发 GC 行为。
并发
Go 常用的并发模型?
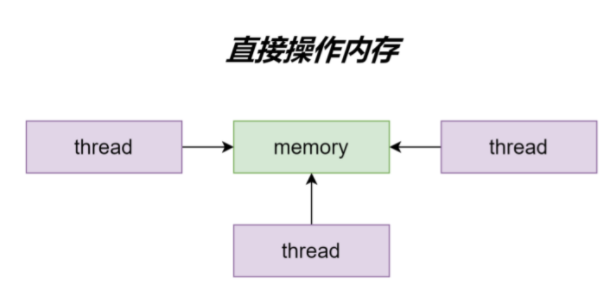
共享内存并发模型
通过直接共享内存 + 锁的方式同步信息,传统多线程并发
CSP并发模型
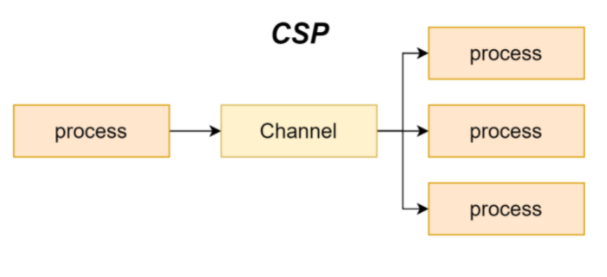
通过发送消息的方式来同步信息,Go语言推荐使用的通信顺序进程(communicating sequential processes)并发模型,通过goroutine和channel来实现
goroutine是Go语言中并发的执行单位,可以理解为”线程“channel是Go语言中各个并发结构体(goroutine)之前的通信机制。 通俗的讲,就是各个goroutine之间通信的”管道“,类似于Linux中的管道
Go WaitGroup实现原理?
概念
Go标准库提供了WaitGroup原语, 可以用它来等待一批 Goroutine 结束
底层数据结构
// A WaitGroup must not be copied after first use.
type WaitGroup struct {
    noCopy noCopy
     state1 [3]uint32
}
其中 noCopy 是 golang 源码中检测禁止拷贝的技术。如果程序中有 WaitGroup 的赋值行为,使用 go vet 检查程序时,就会发现有报错。但需要注意的是,noCopy 不会影响程序正常的编译和运行。
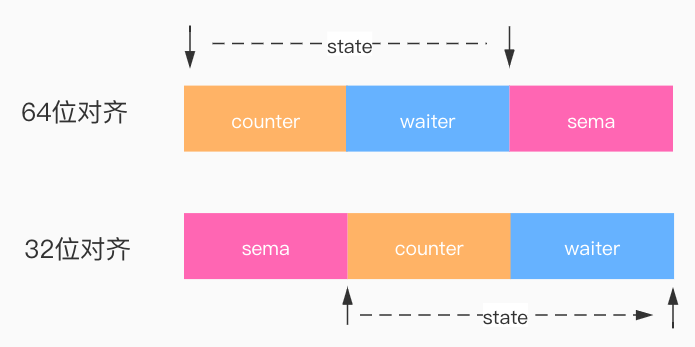
state1主要是存储着状态和信号量,状态维护了 2 个计数器,一个是请求计数器counter ,另外一个是等待计数器waiter(已调用 WaitGroup.Wait 的 goroutine 的个数)
当数组的首地址是处于一个8字节对齐的位置上时,那么就将这个数组的前8个字节作为64位值使用表示状态,后4个字节作为32位值表示信号量(semaphore);同理如果首地址没有处于8字节对齐的位置上时,那么就将前4个字节作为semaphore,后8个字节作为64位数值。
使用方法
在WaitGroup里主要有3个方法:
WaitGroup.Add():可以添加或减少请求的goroutine数量,*Add(n)将会导致counter += n*WaitGroup.Done():相当于Add(-1),Done()将导致counter -=1,请求计数器counter为0 时通过信号量调用runtime_Semrelease唤醒waiter线程WaitGroup.Wait():会将waiter++,同时通过信号量调用runtime_Semacquire(semap)阻塞当前 goroutine
func main() {
    var wg sync.WaitGroup
    for i := 1; i <= 5; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            println("hello")
        }()
    }

    wg.Wait()
}
Go Cond实现原理?
Go标准库提供了Cond原语,可以让 Goroutine 在满足特定条件时被阻塞和唤醒
底层数据结构
type Cond struct {
    noCopy noCopy

    // L is held while observing or changing the condition
    L Locker

    notify  notifyList
    checker copyChecker
}

type notifyList struct {
    wait   uint32
    notify uint32
    lock   uintptr // key field of the mutex
    head   unsafe.Pointer
    tail   unsafe.Pointer
}
主要有4个字段:
nocopy: golang 源码中检测禁止拷贝的技术。如果程序中有 WaitGroup 的赋值行为,使用go vet检查程序时,就会发现有报错,但需要注意的是,noCopy 不会影响程序正常的编译和运行checker:用于禁止运行期间发生拷贝,双重检查(Double check)L:可以传入一个读写锁或互斥锁,当修改条件或者调用Wait方法时需要加锁notify:通知链表,调用Wait()方法的Goroutine会放到这个链表中,从这里获取需被唤醒的Goroutine列表
使用方法
在Cond里主要有3个方法:
sync.NewCond(l Locker): 新建一个 sync.Cond 变量,注意该函数需要一个 Locker 作为必填参数,这是因为在cond.Wait()中底层会涉及到 Locker 的锁操作Cond.Wait(): 阻塞等待被唤醒,调用Wait函数前需要先加锁;并且由于Wait函数被唤醒时存在虚假唤醒等情况,导致唤醒后发现,条件依旧不成立,因此需要使用 for 语句来循环地进行等待,直到条件成立为止Cond.Signal(): 只唤醒一个最先 Wait 的 goroutine,可以不用加锁Cond.Broadcast(): 唤醒所有Wait的goroutine,可以不用加锁
package main

var status int64

func main() {
    c := sync.NewCond(&sync.Mutex{})
    for i := 0; i < 10; i++ {
        go listen(c)
    }
    go broadcast(c)
    time.Sleep(1 * time.Second)
}

func broadcast(c *sync.Cond) {
    // 原子操作
    atomic.StoreInt64(&status, 1)
    c.Broadcast()
}

func listen(c *sync.Cond) {
    c.L.Lock()
    for atomic.LoadInt64(&status) != 1 {
        c.Wait()
        // Wait 内部会先调用 c.L.Unlock(),来先释放锁,如果调用方不先加锁的话,会报错
    }
    fmt.Println("listen")
    c.L.Unlock()
}